阿姆哈拉語:衣索比亞古老的閃米特語言
TABLE OF CONTENTS
唯一一種由左至右書寫、擁有自身兩千年歷史文字的閃米特語言——而且它的「你好」同時也意為「和平」。
語言分類
阿姆哈拉語(አማርኛ,Amarəñña)屬於閃米特語系中的衣索比亞閃米特語支,而閃米特語系本身又是更大亞非語系的一部分。它是全球使用人數第二多的閃米特語言,僅次於阿拉伯語,母語使用者約有 3,500 萬至 4,000 萬人,另有 2,000 萬至 2,500 萬的第二語言使用者。
在衣索比亞閃米特語支內部,阿姆哈拉語與阿爾戈巴語、哈拉里語及古拉格語群等語言同屬南衣索比亞語次群。就共享詞彙而言,與它親緣關係最近的是阿爾戈巴語,不過兩者無法互通。
一個常見的誤解是,阿姆哈拉語直接源自吉茲語(ግዕዝ),也就是衣索比亞正統台瓦西多教會的古老禮儀語言。事實上,兩者是姊妹語言,共享同一個原始衣索比亞閃米特語祖先。阿姆哈拉語與吉茲語的詞彙相似度約為 62%——相當於德語與英語之間的距離。吉茲語在歐洲扮演的角色類似拉丁語:一種保存在禮儀與學術中的古典語言,在不再作為母語使用數百年後,仍持續影響其現代後裔。
使用地區
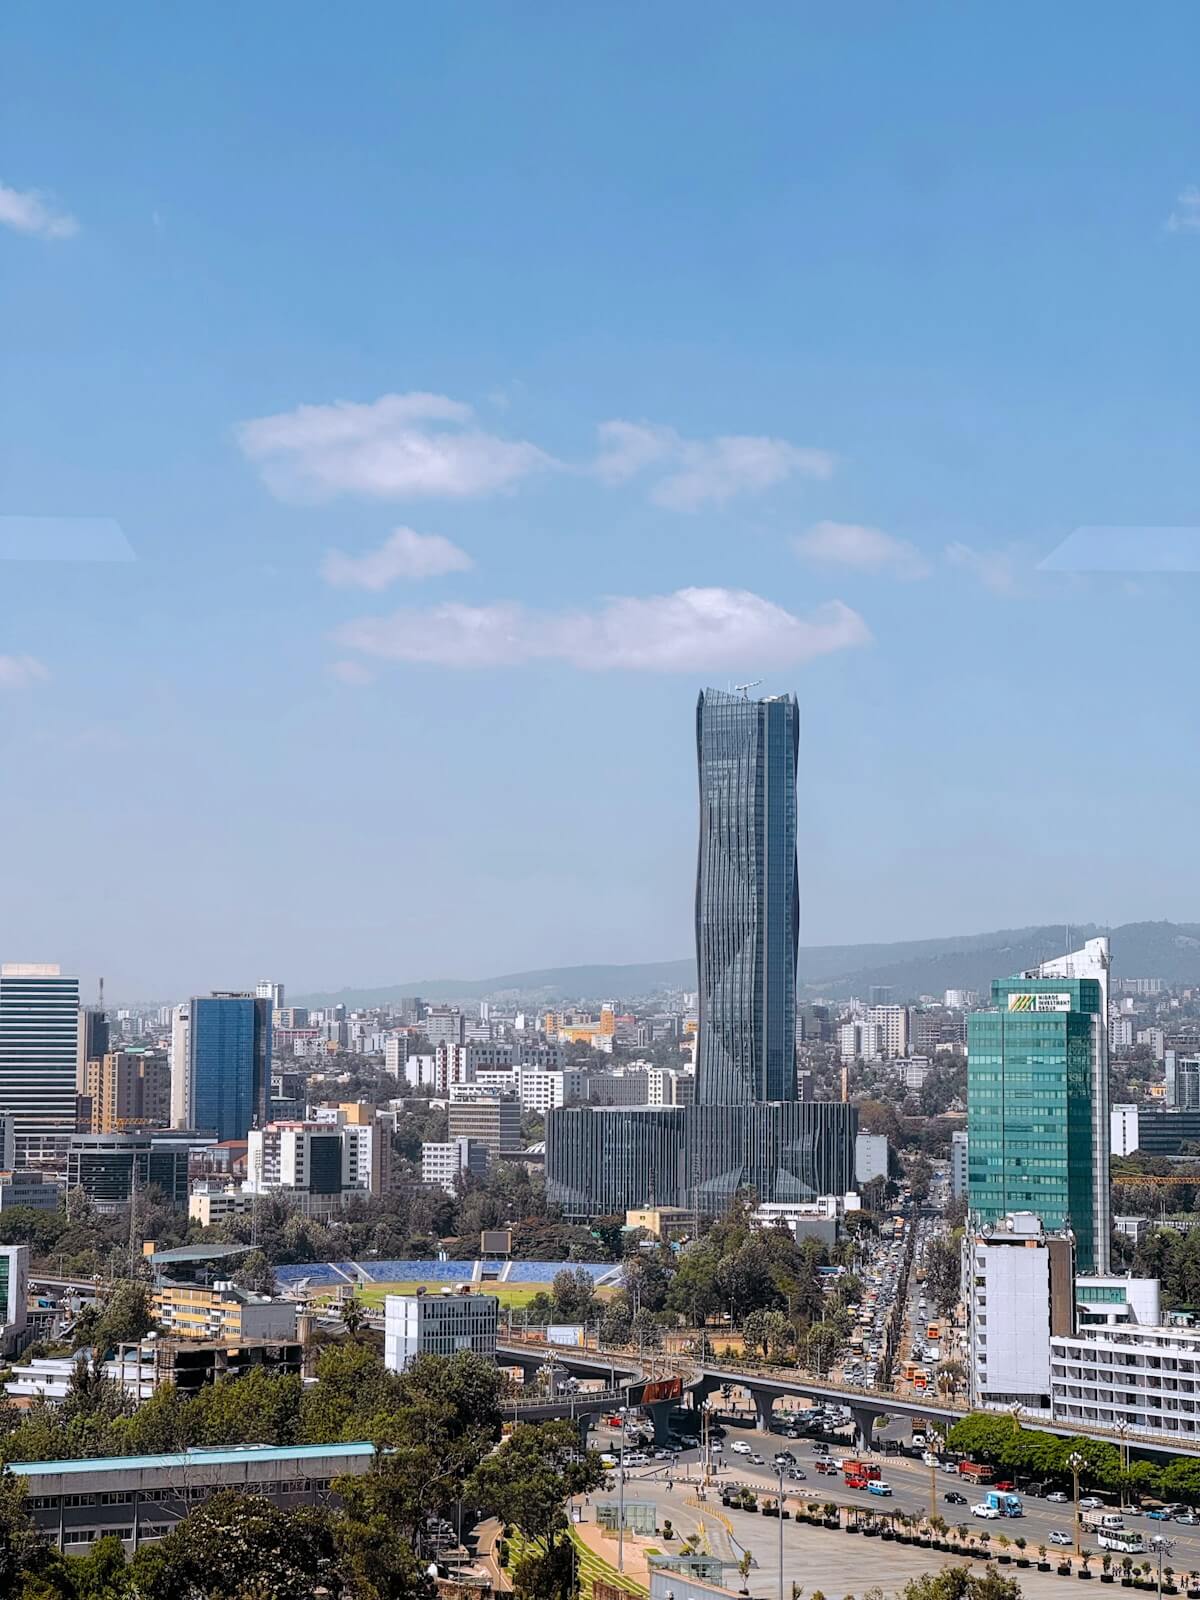
阿姆哈拉語是衣索比亞聯邦民主共和國的官方工作語言。所有聯邦法律都以阿姆哈拉語公布,它也是政府、全國媒體與教育體系使用的語言。此外,它也是數個區域州的官方或工作語言,包括阿姆哈拉州、本尚古勒-古馬茲州、甘貝拉州,以及首都阿迪斯阿貝巴。
在衣索比亞之外,阿姆哈拉語在非洲聯盟擁有工作語言地位。以下地區有規模可觀的僑民社群使用阿姆哈拉語:
| 國家 | 估計使用人數 |
|---|---|
| 美國 | 250,000+(集中於華盛頓特區、明尼蘇達州、加州) |
| 以色列 | 177,600+(貝塔以色列/衣索比亞猶太社群) |
| 加拿大 | 45,000+(多倫多、卡加利) |
| 英國 | 30,000+(倫敦) |
| 瑞典 | 20,000+ |
| 厄利垂亞 | 在邊境地區作為第二語言使用 |
| 吉布地與蘇丹 | 少數語言社群 |
在衣索比亞境內,阿姆哈拉語是全國 80 多個族裔群體之間的通用語。雖然只有約 27% 的衣索比亞人以它為第一語言,但估計有 5,500 萬至 6,500 萬人——超過半數人口——以它作為第一或第二語言。
方言與變體
阿姆哈拉語有五個主要方言區,彼此可以互通,但在發音、詞彙甚至語法上都有明顯差異。阿迪斯阿貝巴變體是媒體、教育與政府所使用的標準語。
| 方言區 | 與標準語的差異 | 主要城市 | 顯著特徵 |
|---|---|---|---|
| 阿迪斯阿貝巴 | 標準 | 阿迪斯阿貝巴 | 具聲望的方言;所有正式阿姆哈拉語的基礎 |
| 戈賈姆 | 差異最大 | 德卜勒馬科斯、巴赫達爾 | /b/ → [w](例如 kəbt → kawt「牛」);獨特的否定副動詞形式,在標準阿姆哈拉語中不可能出現 |
| 貢德爾 | 接近標準 | 貢德爾、德卜勒塔博爾 | 具有阿迪斯阿貝巴阿姆哈拉語所無的形態學未來時;受鄰近的提格利尼亞語影響 |
| 沃洛 | 略有差異 | 德西、韋爾迪亞 | 輔音換位(例如 mārṭābya → māṭrābya「斧頭」);南沃洛變體更接近北紹阿 |
| 紹阿 | 略有差異 | 德卜勒伯爾漢 | 輔音弱化:母音之間 /kʼ/ → [ʔ],/k/ → [h] |
戈賈姆方言值得特別一提。它如此獨特,以至於語言學家孟吉斯圖·塔德塞(Mengistu Tadesse)在 2021 年的重新分類中主張,只有東戈賈姆才應被視為真正獨特的「戈賈姆」變體——西戈賈姆的說話方式其實更接近阿迪斯阿貝巴標準語。戈賈姆最引人注目的特徵,是把否定副動詞當作獨立的動詞形式使用(al-bälto-mm「他沒吃」),這在標準阿姆哈拉語中是不可能的事。
另一種變體是猶太阿姆哈拉語,由貝塔以色列(衣索比亞猶太)社群使用,如今主要僅存於以色列。它融入了猶太特有的詞彙——例如把某種蚱蜢稱為「摩西的馬」,而非基督教的「馬利亞的馬」。隨著年輕世代轉向現代希伯來語,這種變體正逐漸式微。
歷史
阿姆哈拉語的歷史,與衣索比亞高地的政治及人口歷史密不可分。
古老的根源
說閃米特語的民族早在西元前 500 年之前,就已從南阿拉伯跨越紅海進入衣索比亞高地,語言證據顯示其存在可能早至西元前 2000 年。這些移民帶來了原始衣索比亞閃米特語的祖先,該語言最終分裂為北支(衍生出吉茲語與提格利尼亞語)與南支(衍生出阿姆哈拉語及其親屬語言)。
阿克蘇姆王國(約西元 100–940 年)是晚期古代最偉大的文明之一,以吉茲語作為書面語言。此時期的阿姆哈拉語則是一種尚未有文字的日常口語,在如今阿姆哈拉地區的巴希洛河流域發展。
庫施語底層
這是關於阿姆哈拉語演變最重要的一項事實:阿姆哈拉人原本是阿高(中庫施語)使用者,後來採用了移入定居者的閃米特語言。當他們歷經數代轉換語言時,仍保留了原本庫施語的句法模式。
結果就是一種以閃米特詞彙為表、庫施語語法為骨的語言。這幾乎可以解釋現代阿姆哈拉語所有「非閃米特」的特徵:主賓謂(SOV)語序、後置詞,以及置於名詞前的關係子句。
崛起為要角
| 時期 | 里程碑 |
|---|---|
| 西元 4–9 世紀 | 原始阿姆哈拉語作為獨特的口語變體出現 |
| 12 世紀晚期 | 成為宮廷與軍隊的工作語言 |
| 1270 | 葉庫諾·阿姆拉克皇帝將阿姆哈拉語定為 Lisane Negus——「國王的語言」 |
| 14 世紀 | 首批書面紀錄;阿姆達·塞永的「勝利之歌」 |
| 14–17 世紀 | 快速的語法重組:VSO → SOV、喉音輔音消失、後置詞發展 |
| 19 世紀 | 吉茲語不再是官方書面語言,由阿姆哈拉語取代 |
| 1995 | 衣索比亞憲法指定阿姆哈拉語為聯邦工作語言 |
衣索比亞帝國重心南移——從舊阿克蘇姆北方轉向阿姆哈拉腹地——奠定了阿姆哈拉語的優勢地位。到了 19 世紀,特沃德羅斯二世與孟尼利克二世等皇帝,把阿姆哈拉語當作在新統一的衣索比亞國家中推行中央集權的工具。
洋涇浜化之爭
萊昂內爾·班德(Lionel Bender,1983)提出,阿姆哈拉語可能起源於一種洋涇浜語,用以讓說閃米特語、庫施語與奧莫語的阿克蘇姆士兵彼此溝通。儘管這個理論仍有爭議——吉爾馬·德梅克(Girma Demeke)稱其「明顯難以置信」,並主張大多數非閃米特特徵都是晚近的創新——但它凸顯出阿姆哈拉語因語言接觸而產生的變化程度,在閃米特語族中確實非比尋常。
《大英百科全書》(1911)精準地捕捉了這個悖論:「一個從未學過任何閃米特語言的人,在掌握阿姆哈拉語結構時所遇到的困難,甚至會比一個熟悉閃米特語法的人更少——這樣說幾乎不算誇張。」
書寫系統
用來書寫阿姆哈拉語的吉茲字母(ፊደል,Fidäl),是全球最具特色的書寫系統之一——也是非洲少數至今仍廣泛使用的本土文字之一。
結構:元音附標文字
吉茲字母是一種元音附標文字(abugida,又稱音節-字母文字),意思是每個基本字符代表一個輔音加上一個固有的母音,其他母音則透過系統性地修改基本字形來標示。不同於純字母系統(輔音與母音是各自獨立的字母)或音節文字(每個音節都是互不相關的符號),元音附標文字介於兩者之間——而吉茲字母可說是這類文字中最規則的範例。就像喬治亞的姆赫德魯利字母一樣,它是少數仍被數百萬使用者積極使用的本土文字,但其元音附標結構使它不同於喬治亞純粹的字母系統。
阿姆哈拉語使用 34 個基本輔音字符,每個字符有 7 種母音形式(稱為「序」),共產生約 238 個核心音節字符:
| 序 | 母音 | 以 /l/ 為例 | 修改方式 |
|---|---|---|---|
| 第 1 序(Ge’ez) | ä /ə/ | ለ lä | 基本形 |
| 第 2 序(Kä’ib) | u /u/ | ሉ lu | 右側加一橫短線 |
| 第 3 序(Säləs) | i /i/ | ሊ li | 右下角加一橫筆 |
| 第 4 序(Rab’ə) | a /a/ | ላ la | 右腿拉長 |
| 第 5 序(Ḫaməs) | e /e/ | ሌ le | 右下角加小圓環 |
| 第 6 序(Sadəs) | ə /ɨ/ | ል lə | 不規則——因輔音而異 |
| 第 7 序(Sab’ə) | o /o/ | ሎ lo | 修改左腿或加頂部圓環 |
這個規律出乎意料地好學。第 2 到第 5 序在大多數輔音上都高度規則。第 6 與第 7 序則是得靠死記硬背的地方。
字符衍生——內建的邏輯
這套文字最優雅的特點之一,是新字符如何從既有字符衍生而來。為了表示進入阿姆哈拉語、但古典吉茲語中沒有的音,抄寫者會在視覺上相關的字符加上一筆頂部橫線:
| 原始 | 音 | 修改後 | 音 |
|---|---|---|---|
| በ | b | ቨ | v |
| ተ | t | ቸ | č (ch) |
| ደ | d | ጀ | ǧ (j) |
| ሰ | s | ሸ | š (sh) |
| ነ | n | ኘ | ñ (ny) |
這種衍生邏輯——新符號在視覺上與系統性地和它們所代表的音相關——在世界各地的書寫系統中相當罕見。
唇化軟顎音
一個獨特的特徵是,唇化軟顎輔音(發音時雙唇呈圓形的輔音:/kʷ/、/gʷ/、/qʷ/、/xʷ/)另有一組獨立字符。這些字符在視覺上截然不同,且只有五種母音形式,而非七種:
| 基本 | 非唇化 | 唇化 |
|---|---|---|
| k | ከ | ኰ |
| g | ገ | ጐ |
| q | ቀ | ቈ |
| x | ኸ | ዀ |
其他特點
- 書寫方向:由左至右——這在閃米特文字中很不尋常(阿拉伯語與希伯來語是由右至左)
- 大小寫:沒有大寫/小寫之分
- 分詞方式:傳統上以兩點符號 ፡ 分隔詞語(不過現代印刷常使用空格)
- 標點:具有獨特的標點符號,包括 ።(句號)、፣(逗號)、፤(分號)與 ፨(分段符)
- 數字:這套文字有自己的數字系統(፩=1、፪=2……፲=10、፳=20……፻=100、፼=10,000)
- 語音一致性:幾乎沒有不發音的字母或不規則拼寫——看到什麼就唸什麼
多餘的字母
對學習者而言的一個小麻煩:阿姆哈拉語保留了幾個源自吉茲語、但在現代發音中代表同一個音的字符。例如 ሀ、ሐ、ኀ 與 ኸ 在阿姆哈拉語中都代表 /h/(它們在古典吉茲語中原本有區別)。同樣地,ሰ 與 ሠ 都代表 /s/,而 ጸ 與 ፀ 都代表 /tsʼ/。這些都保留在傳統拼寫中,必須一個詞一個詞地記住。
音系
阿姆哈拉語的語音系統,正是其閃米特淵源與庫施語影響同時充分展現的地方。
擠喉輔音
阿姆哈拉語音系最突出的特徵,是它的五個擠喉輔音系列——這些音不是用肺部氣流發出,而是在聲門緊閉的情況下把空氣困在口腔中,再以急促的爆破噴出:
| 擠喉音 | IPA | 文字 | 非擠喉對應音 | 濁音對應音 |
|---|---|---|---|---|
| p’ | /pʼ/ | ጰ | p (ፐ) | b (በ) |
| t’ | /tʼ/ | ጠ | t (ተ) | d (ደ) |
| s’ (ts’) | /sʼ/ 或 /tsʼ/ | ጸ | s (ሰ) | z (ዘ) |
| č’ | /tʃʼ/ | ጨ | č (ቸ) | ǧ (ጀ) |
| k’ | /kʼ/ | ቀ | k (ከ) | g (ገ) |
要發出擠喉音:短暫憋氣,在口腔中累積氣壓,然後以急促、受控的爆破釋放。這種音帶有一種獨特的「喀噠」感,與英語中任何音都截然不同。
擠喉擦音 /sʼ/(ጸ)尤其罕見——世界上很少有語言把擠喉機制延伸到擦音。阿姆哈拉語還允許擠喉輔音延長(拉長/重疊),為音位對比增添另一層次。
這些音會造成意義上的區別——也就是最小對比組,其中擠喉音與非擠喉音的對比會完全改變詞義:
- ቃል(kʼal)「話語、承諾」對比 ካል(kal)「說」
- ጠኛ(tʼäñña)「守衛」對比 ተኛ(täñña)「睡覺」
輔音延長
輔音延長(輔音重疊)在阿姆哈拉語中具有音位功能——它能區分其他方面完全相同的詞。alä「他說」與 allä「有」之間的差別,完全在於 /l/ 要持續多久。這項特徵與阿拉伯語及其他閃米特語言共有,但阿姆哈拉語甚至把它套用在擠喉音上,這在跨語言的角度相當罕見。
至關重要的是,延長在書寫中並不標示。同一個書面形式可以表示「他打」(yemätall)或「他被打」(yemmättall),只能靠上下文與讀者的知識來分辨。這是阿姆哈拉語對人類學習者與自然語言處理系統而言最困難的環節之一。
母音系統
阿姆哈拉語有一套相對簡單的七母音系統:
| 母音 | IPA | 例子 |
|---|---|---|
| ä | /ə/ 或 /ɐ/ | ለ lä |
| u | /u/ | ሉ lu |
| i | /i/ | ሊ li |
| a | /a/ | ላ la |
| e | /e/ | ሌ le |
| ə | /ɨ/ | ል lə |
| o | /o/ | ሎ lo |
央母音 /ɨ/ 與 /ə/ 對英語使用者來說可能頗具挑戰,因為英語沒有與高央母音 /ɨ/ 完全對應的音。
語法
阿姆哈拉語的語法,最能體現這門語言兼具閃米特與庫施雙重身分。它的詞彙與詞根系統無疑是閃米特式的。它的語序與句子結構則無疑是庫施式的。結果就是一種在閃米特語族中獨一無二的語法。
詞根與詞型系統
和阿拉伯語、希伯來語一樣,阿姆哈拉語以輔音詞根建構詞彙——通常是三個承載抽象意義的輔音——再套入表達語法區別的母音詞型中:
| 詞根 | 意義 | 形式 |
|---|---|---|
| s-b-r | 打破 | säbbär-ä「他打破了」、yə-säbr「他打破」、səbabbar-「反覆打破成碎片」 |
| g-d-l | 殺 | gäddäl-ä「他殺了」、yə-gädl「他殺」、tä-gäddäl-ä「他被殺了」 |
| l-b-s | 穿 | läbbäs-ä「他穿了」、a-läbbäs-ä「他讓某人穿上衣服」、tä-läbbäs-ä「他穿好了衣服」 |
這套系統不只限於三輔音詞根。阿姆哈拉語允許四輔音詞根,甚至更長的詞根,通常透過重疊來創造——重複詞根的一部分以表達強烈或反覆。
以延長與重疊表達意義
阿姆哈拉語運用輔音拉長與音節重複,不僅用於詞彙對比,也當作具生產力的語法工具:
| 形式 | 模式 | 意義 |
|---|---|---|
| säbbär-ä | 詞根延長 | 「他打破了」(單純動作) |
| səbbərr- | 強調式延長 | 「徹底打破」 |
| sabarr- | 減弱式 | 「輕輕打破」 |
| sababbar- | 第一級重疊 | 「反覆打破」 |
| səbbərbərr- | 第二級重疊 | 「徹底打破成碎片」 |
重疊的第三級是開放式的——說話者可以一直類推下去,直到表達出想要的強度。這種象似性構詞法(形式愈多=意義愈多)在閃米特語中相對罕見,很可能反映了庫施語的影響。
主賓謂語序
這是與古典閃米特語最大的句法分歧。阿拉伯語、希伯來語與吉茲語使用 VSO(謂語-主語-賓語),阿姆哈拉語則使用 SOV(主語-賓語-謂語):
阿姆哈拉語:Almaz buna t’ättačč.
(Almaz 咖啡 她喝了 =「Almaz 喝了咖啡。」)
阿拉伯語對應句:Šaribat Almaz al-qahwa.
(她喝了 Almaz 這咖啡。)
動詞永遠在最後。後置詞取代了前置詞。關係子句與形容詞置於它們所修飾的名詞之前——這又是對典型閃米特模式的另一種倒轉。
動詞上的主語標記
阿姆哈拉語動詞透過後綴強制標示主語。英語中那種不帶標記的動詞在這裡並不存在——每個動詞形式都編碼了人稱、數,以及(在第二與第三人稱單數中)性別:
| 人稱 | 後綴 | 例子(詞根 sbr「打破」) |
|---|---|---|
| 我 | -ku | säbbär-ku「我打破了」 |
| 你(陽性) | -k | säbbär-ək「你(陽性)打破了」 |
| 你(陰性) | -š | säbbär-əš「你(陰性)打破了」 |
| 他 | -ä | säbbär-ä「他打破了」 |
| 她 | -äčč | säbbär-äčč「她打破了」 |
| 我們 | -n | säbbär-ən「我們打破了」 |
| 他們 | -u | säbbär-u「他們打破了」 |
敬語形式
這是大多數其他閃米特語言所沒有的特徵:阿姆哈拉語為第二與第三人稱代名詞及其對應的動詞變化,發展出獨特的敬語/正式形式。這很可能是它在長達千年作為行政與宮廷語言的過程中形成的:
| 人稱 | 普通 | 敬語 |
|---|---|---|
| 你(單數) | antä(陽性)/anči(陰性) | əssəwo(性別中立) |
| 他/她 | əssu/əsswa | əssaččäw |
詞彙與借詞
約 73% 可辨識的阿姆哈拉語詞根源自閃米特語,在高頻日常詞彙中更上升到約 85%。其餘的詞庫則反映了衣索比亞身處語言接觸十字路口的位置。
| 來源 | 例子 |
|---|---|
| 庫施語(阿高語) | wəšša「狗」、dul「堆、塊」、gərär「某種樹」——這些日常詞彙往往來自最初的阿高語底層 |
| 阿拉伯語 | mäskid「清真寺」、bərr「門」、sälam「和平」——宗教與商業術語 |
| 吉茲語 | məslä「與」、nəguś「國王」、betä krəstiyan「教堂」——正式、宗教與文學詞彙;很像英語中的拉丁語借詞 |
| 義大利語 | bänna「廂型車」、borsa「袋子」、čaw「再見」(源自 ciao)、bira「啤酒」(源自 birra)、posta「郵件」——短暫義大利占領時期(1936–1941)的遺產 |
| 英語 | telefon、kompyuter——現代科技與全球性詞彙 |
| 葡萄牙語 | bäqqolo「某種麵包」——來自 16 世紀葡萄牙耶穌會士的接觸 |
義大利語的影響具體得令人玩味。僅僅五年的占領之後,阿姆哈拉語吸收了至今八十多年後仍存在的日常詞彙。走在阿迪斯阿貝巴街頭,你可以用 čaw 說再見,點一杯 bira——兩者都是那段短暫殖民接觸留下的活痕跡。
常用短語
阿姆哈拉語的問候語出了名地講究——一句簡單的「嗨」可能演變成長達數輪、關於健康、家庭與神祝福的交流。以下是最基本的幾句:
| 中文 | 阿姆哈拉語 | 發音 |
|---|---|---|
| 你好/和平 | ሰላም | sä-lam (seh-LAHM) |
| 早安 | ደህና አደርክ(對男性)/አደርሽ(對女性) | deh-na a-der-ik/a-der-ish |
| 你好嗎? | እንዴት ነህ?(對男性)/ነሽ?(對女性) | ən-det neh?/nesh? |
| 我很好 | ደህና ነኝ | deh-na näñ |
| 謝謝 | አመሰግናለሁ | a-me-sä-gə-na-lä-hu (ah-meh-seh-gun-AH-leh-hoo) |
| 不客氣 | ምንም አይደል | mən-nəm ay-del(字面意為「沒什麼」) |
| 請 | እባክህ(對男性)/እባክሽ(對女性) | ə-bak-əh/ə-bak-əš |
| 不好意思/抱歉 | ይቅርታ | yə-qər-ta |
| 再見 | ደህና ሁን(對男性)/ሁኚ(對女性) | deh-na hun/hun-yi |
| 再見(非正式) | ቻው | čaw(源自義大利語 ciao) |
| 是/否 | አዎ/አይ | awo/ay |
| 願神祝福你 | እግዚአብሔር ይመስገን | əg-zi-ab-her yəm-mäs-gän |
請注意,即使在基本問候語中,性別也決定了動詞結尾。對男人說「你好嗎」用 neh,對女人用 nesh,對長輩或一群人則用 naččäw。用對與否,就是禮貌與尷尬之間的差別。
阿姆哈拉語偏好拉長問候,意味著 Sälam! Endet neh? Dehna näñ. Igziabher yəmmäsgän.(「你好!你好嗎?我很好。願神受讚美。」)這樣的一來一往很容易變成一場兩分鐘的儀式——略過它會顯得無禮。
學起來難嗎?
美國外交學院(FSI)將阿姆哈拉語歸類為 Category IV——對英語使用者而言屬於「困難」級——大約需要 44 週或 1,100 小時的課堂學習才能達到專業工作程度。這使它與印地語、俄語、希臘語和泰語同級——比羅曼語族與日耳曼語族更難,但不像阿拉伯語、華語、日語或韓語那麼難(Category V,88 週)。
困難之處
文字系統。 在沒有拉丁字母輔助的情況下學習 238 個以上的音節字符,是第一道主要障礙。雖然母音變化比乍看之下更有規律,但第 6 與第 7 序仍需要純粹的死記。那些多餘的字符(四種寫 /h/ 的方式)又增加了額外的記憶負擔。
擠喉輔音。 發出尖銳的 /kʼ/ 或 /tʼ/ 是英語使用者從未練習過的動作技能。要花上好幾週的反覆練習,kal(「說」)與 kʼal(「話語」)之間的區別才會變得自動化。
主賓謂語序。 英語使用者習慣動詞緊跟在主語之後。在阿姆哈拉語中,你可能得在腦中記住好幾個名詞與副詞,直到動詞出現在句尾才完成整個意思。
性別一致。 每個句子都必須追蹤你是在對男人、女人還是一群人說話——並據此調整動詞後綴。
未標示的輔音延長。 由於雙輔音的區別不寫出來,你無法單靠「讀」來判斷一個詞是否有延長輔音。你必須知道。
比你想像中容易的地方
拼寫與發音一致。 不同於英語或法語,阿姆哈拉語的書寫幾乎與發音完全一致。沒有不發音的字母、沒有不規則拼寫、沒有模稜兩可的字母組合。學會文字之後,你就能唸出任何看到的詞。
沒有任意的性別。 阿姆哈拉語的語法性別是自然性別——它跟隨生物性別。桌子不是「陽性」或「陰性」;它就是桌子。這比法語或德語簡單得多,後者每個名詞都有必須記憶的任意性別。
規則的構詞方式。 詞根與詞型系統一旦內化,你往往就能靠辨認詞根輔音來猜出陌生詞彙的意思。
沒有格系統。 不像俄語(6 個格)或芬蘭語(15 個格),阿姆哈拉語的名詞不進行變格。詞與詞之間的關係透過語序與後置詞表達,而非格尾。
學習建議
先精通文字。 把最初的 1–2 週專門用來學 Fidäl。重點在於把 34 個基本字符及其 7 種序當作一個系統來學——這些規律相當規則,因此死記 238 個個別符號是錯誤的做法。對大多數輔音而言,第 2 到第 5 序都遵循可預測的修改規則。第 6 與第 7 序才是需要字卡的時候。
從第 1 序開始。 基本形(吉茲序,母音 /ə/)最為常見。能夠辨認基本字符,會比試圖一次掌握全部七種序更快讓你達到實用的半讀寫能力。
及早練習擠喉音。 錄下自己說 kal 與 kʼal 這類最小對比組,再與母語者的音檔比較。你愈早訓練這個動作模式,日後需要改掉的習慣就愈少。
使用 FSI 的免費阿姆哈拉語基礎課程。 美國外交學院的阿姆哈拉語教材——最初為外交官編寫——屬於公共領域,可在網路上免費取得。它們至今仍是這門語言最好的系統性入門之一。
找一位衣索比亞語伴。 說阿姆哈拉語的社群在 HelloTalk、Tandem 與 iTalki 上都很活躍。母語者通常很樂見外國人嘗試他們的語言,也會樂意帶你走過那套拉長問候的儀式。
透過音樂與 YouTube 沉浸。 衣索比亞音樂(從令人著迷的 tizita 敘事歌謠到現代衣索比亞爵士)富含咬字清晰的阿姆哈拉語歌詞。像 Amharic4Rastafari 與 Learn Amharic with Tiblet 這樣的 YouTube 頻道,提供有系統的影片課程。
有機會就去阿迪斯阿貝巴。 在佔地廣闊的 Merkato 市場、Piazza 的爵士俱樂部,或是在 Tomoca Coffee 喝一杯 macchiato 時聽見阿姆哈拉語,是無可替代的體驗。衣索比亞首都是非洲最有活力的城市之一,全面沉浸會大幅加速你的進步。
AI 翻譯與阿姆哈拉語
阿姆哈拉語體現了低資源語言在 AI 翻譯上的結構性挑戰。儘管擁有超過 5,500 萬使用者,它在已索引網路內容中只占約 0.0036%——大約每 28,000 頁中才有 1 頁。阿姆哈拉語維基百科約有 15,000 條目,而英文版則有 600 多萬條。
三大核心問題
分詞懲罰。 由於吉茲文字在主要以拉丁字母資料訓練的分詞器中代表性不足,單一個阿姆哈拉語詞可能被切成比英文對應詞多 5–10 倍的分詞。ኢትዮጵያ(「衣索比亞」)這個詞會消耗 10 個分詞,而 “Ethiopia” 只需 3 個。這使得阿姆哈拉語的 AI 互動更昂貴、更慢、能力更差——模型的上下文視窗更快被填滿,留給實際推理的空間更少。
羅馬化阿姆哈拉語的盲點。 數以百萬計的城市衣索比亞人在社群媒體上用拉丁字母以拼音書寫阿姆哈拉語:「Selam endet neh?」而不是「ሰላም እንዴት ነህ?」。AI 訓練流程把它誤判為混亂的英語而忽略。大量真實的對話資料因此貢獻了零訓練訊號。
經濟誘因不足。 前沿 AI 公司針對以美元計價的市場進行最佳化。阿姆哈拉語使用者——儘管人數達數千萬——並不代表那種能驅動產品路線圖的市場。實際上沒有阿姆哈拉語的 RLHF 標註員、沒有阿姆哈拉語的安全測試,推理鏈也一路到底都是英語。
2025–2026 年的進展
已有進展的跡象。Google AI Overviews 已擴展支援阿姆哈拉語的輸入與語音查詢。AfriNLLB 計畫發布了源自 NLLB-200 的輕量壓縮模型,支援阿姆哈拉語及其他 14 種非洲語言,並針對資源受限環境的部署進行最佳化。草根研究社群 Masakhane 則持續建構開放的阿姆哈拉語資料集與模型,針對非洲的語言現實設計,而非沿用英語中心的架構。
學術努力也在累積:AFRIDOC-MT 語料庫為英語-阿姆哈拉語提供健康與 IT 領域的文件級平行資料,而 LLaMA-2-Amharic 指令微調資料集也正由衣索比亞的 NLP 研究者陸續推出。
在日常翻譯任務上,OpenL 支援阿姆哈拉語及 100 多種語言,為需要快速、可靠翻譯的使用者與學習者提供一個易用的選擇,且沒有通用聊天機器人的分詞負擔與文化盲點。如果你正在更廣泛地比較翻譯工具,請參閱我們的2026 年最佳免費線上翻譯工具指南。
趨勢是正面的,但差距依然很大。要縮小差距,不僅需要更好的模型,還需要刻意投資於阿姆哈拉語資料的建立、能辨識文字的分詞方式,以及母語者參與的評估框架。
Sources
- Amharic — Wikipedia — comprehensive overview of classification, phonology, grammar, and dialects
- Ge’ez script — Wikipedia — detailed description of the writing system’s structure and history
- Ethiopian Semitic languages — Wikipedia — classification and historical development of the Ethio-Semitic branch
- Amharic — The Languages of Berkeley — accessible introduction to the language’s history and structure
- FSI Amharic Basic Course — free public-domain course materials from the U.S. Foreign Service Institute
- Amharic — Britannica — authoritative overview of the language
- Is Amharic Hard To Learn? — Ling App — learner-focused difficulty breakdown
- Amharic Dialects — Mengistu Tadesse — 2021 re-classification of Amharic dialect regions
- Why Can’t LLMs Speak Amharic? — StockMarket.et — analysis of economic barriers to Amharic AI
- Africa Speaks 2,000 Languages. Can AI Keep Up? — Tech4D — overview of AI challenges for African languages
- Amharic MT Systematic Review — Frontiers in AI — 2025 academic survey of Amharic machine translation progress
- Preply — Amharic Greetings — practical phrase guide with pronunciation
- Preply — Amharic Minimal Pairs — ejective vs. plain consonant examples