蒙古語:垂直書寫的語言
 加入 Chrome
TABLE OF CONTENTS
蒙古語看起來可能像兩種不同的語言:烏蘭巴托的西里爾字母文本,以及內蒙古的傳統文字垂直欄列。它們同屬一個更廣闊的語言世界,由遷徙、文字改革,以及一套透過詞尾構築意義的文法所形塑。
蒙古語概覽
蒙古語屬於蒙古語族。蒙古國的主要標準語是喀爾喀蒙古語(Khalkha Mongolian),而相關的變體則通行於中國北部及俄羅斯部分地區。
| 問題 | 簡答 |
|---|---|
| 語系 | 蒙古語族;喀爾喀語是蒙古國的全國標準語 |
| 主要國家 | 蒙古國 |
| 其他主要地區 | 中國的內蒙古;俄羅斯的布里亞特(Buryat)及其他蒙古語族社群 |
| 官方地位 | 依 1992 年憲法第 8(1) 條,為蒙古國法定國家語言 |
| 當前人口基準 | 世界銀行 2025 年估計蒙古國有 3,568,978 名居民;這是國家數字,而非使用人數 |
| 最佳的帶日期使用人數估計 | 2005 年有 520 萬名使用者;沒有涵蓋所有變體、可直接比較的 2026 年總數 |
| 書寫系統 | 蒙古國使用蒙古西里爾字母;傳統蒙古文在內蒙古及蒙古國的文字復興工作中仍居核心地位 |
最後這項區別很重要。一個國家的人口數不等於說某種語言的人數,而族裔普查也不自動等同於語言普查。最清楚的帶日期公開估計記錄了2005 年有 520 萬名使用者。它可作為規模參考,而非 2026 年的人口普查:較新的資料來源對喀爾喀語、內蒙古各變體、布里亞特語、衛拉特語(Oirat)及第二語言使用者的劃分方式各不相同。
蒙古語的使用地區
蒙古語最好理解為一個語言連續體,而非終止於蒙古國邊界的界線。
- 蒙古國: 喀爾喀蒙古語用於政府、教育、媒體及日常生活。語言課程所說的「蒙古語」,大多指的就是這個變體。
- 中國內蒙古: 傳統蒙古文仍可見於學校、出版、公共標誌及文化機構。察哈爾(Chakhar)、鄂爾多斯(Ordos)、與布里亞特相關及其他變體,都是該地區更廣闊蒙古語族景觀的一部分。
- 俄羅斯: 布里亞特語與卡爾梅克語(Kalmyk)是各自擁有文學史與語言政策的獨立蒙古語族語言或主要變體。它們與蒙古語相關,但學習喀爾喀語的人不應假定它們可以互換。
實際的原則很簡單:若內容以蒙古國為對象,在大多數旅遊、學習或商務情境中請選用喀爾喀蒙古語。在翻譯來自內蒙古或俄羅斯的家庭、學校或政府資料前,請先確定地區。
語言與文化在蒙古國最大的公共傳統中直接交會。那達慕節指南 說明了 naadam、deel 和 uukhai 等蒙古語詞彙,並呈現人們實際使用它們的情境。
一種語言,兩大書寫系統
蒙古語令人難忘的特點,不僅在於它使用不止一種文字。這些文字排列文本的視覺方向也各不相同。
| 文字 | 你最可能看到的地方 | 視覺特徵 |
|---|---|---|
| 蒙古西里爾字母 | 蒙古國的日常印刷品、網路、教育及政府文本 | 水平行;在熟悉的西里爾字母組中加入 ө 和 ү |
| 傳統蒙古文 | 內蒙古、文化遺產書寫、書法及蒙古國的文字復興工作 | 由上而下書寫的垂直欄列 |
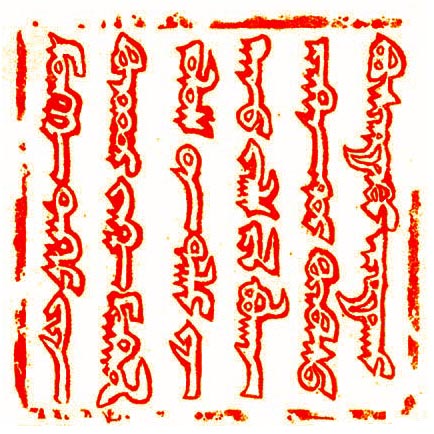
貴由汗(Güyük Khan)1246 年印璽上的傳統蒙古文。來自 Wikimedia Commons 的公有領域圖片。
因此,同一句話可能看起來截然不同。以西里爾字母書寫時,「蒙古語」是 Монгол хэл(Mongol khel)。以傳統文字書寫時,它呈現為 ᠮᠣᠩᠭᠤᠯ ᠬᠡᠯᠡ。這些字母不是裝飾性的字體替換:傳統蒙古文具有位置變體、連字,以及取決於字元在詞中位置的塑形規則。
轉換也不是機械式的一字母替換。傳統拼寫保留了較古老的形式,而內蒙古的書面用法也不總是與現代喀爾喀詞彙或發音相符。可靠的轉換可能需要先選擇一個地區標準,並在改變文字之前先釐清該詞。
Unicode 將蒙古文視為一種具有位置變體與特殊塑形行為的專用文字。這就是為什麼一份傳統文字文件可能包含正確的碼位,卻仍在缺乏合適字型或文字渲染器的應用程式中顯示不良。
蒙古國的文字復興也是當前進行式,而非純然歷史。自 1994 年以來,重新引入的努力持續不斷,傳統文字在某種程度上被教授,而西里爾字母仍居主導地位。傳統文字仍具機構、文化及跨境的重要性。
在比較語言歷史時,這種對比很有用。亞塞拜然語 也有涉及阿拉伯字母、拉丁字母與西里爾字母的現代故事,而喬治亞語則展現了一個語言社群保留獨特文字傳統、而非改用區域字母時會發生什麼事。
蒙古語如何演變出這些文字
傳統蒙古文約在十三世紀初,即成吉思汗(Chinggis Khaan)時期,改編自古回鶻字母。它成為蒙古文化世界大部分地區共享的書面傳統,而衛拉特社群後來為自己的變體發展出更為表音的托忒文(Todo script)。
現代的區隔來自政治,而非蒙古語突然變成兩種互不相關的語言。蒙古國在二十世紀與蘇聯結盟,帶來了短暫的拉丁字母實驗,隨後在 1940 年代採用西里爾字母為基礎的字母表。內蒙古並未跟隨同樣的制度轉變,因此垂直文字在當地保有更大的角色。
蒙古國民主轉型之後,傳統文字重返學校、公共象徵、設計及官方語言規劃,卻沒有取代西里爾字母在日常閱讀中的地位。這就是為什麼文字選擇如今暗示著一份文件的受眾:西里爾字母通常指向現代蒙古國,而傳統文字往往指向內蒙古、文化遺產資料或正式雙語場合。這是線索,而非完美的地理標籤。
蒙古語的發音
蒙古語的發音,值得你多注意母音,而非背誦冗長的拼寫清單。
母音和諧
許多後綴會改變自身的母音,以配合該詞的母音類別。以下的「前/後」標籤是課堂上的簡便說法:現代語言學分析往往透過舌根或咽部對立來描述喀爾喀語的和諧,而非僅憑字面上的舌位。
| 組別 | 常見母音 | 粗略描述 |
|---|---|---|
| 後 | а, о, у | 舌位較靠後發出 |
| 前 | э, ө, ү | 舌位較靠前發出 |
| 中性 | и | 通常本身不決定和諧類別 |
字母 ө 和 ү 值得早早練習。Ө 是前圓母音,有點像法語 peu 中的母音;ү 是前圓高母音,類似德語 ü。英文沒有完全對應的音,所以聆聽比一字母的發音指南更重要。
母音長度能改變意思。比較 будах(budakh,「塗抹或染色」)與 буудах(buudakh,「射擊」):重複的母音不是裝飾性的拼寫。蒙古語也使用 х 等對英語使用者來說可能陌生的子音。羅馬化對於初次接觸很有用,但它隱藏了在西里爾字母中顯而易見的區別。
像積木般組詞的文法
蒙古語是黏著語:一個詞可以接上一連串後綴,每個後綴貢獻相當具體的一部分意義。
| 特徵 | 對學習者意味著什麼 |
|---|---|
| 主語-賓語-動詞語序 | 動詞通常出現在句尾:「我 書 讀。」 |
| 格後綴 | 名詞詞尾標示位置、方向、所屬及來源 |
| 沒有文法性別 | 名詞不像法語名詞那樣分為陽性與陰性類別 |
| 後置詞 | 有些由英語介詞表達的關係,置於名詞之後 |
| 母音和諧 | 後綴的母音會配合它所附加的詞 |
用一個名詞來看,格的模式更容易理解:
| 形式 | 轉寫 | 意思 |
|---|---|---|
| гэр | ger | 房子 |
| гэрт | ger-t | 在房子裡 |
| гэрээс | ger-ees | 從房子 |
| гэрийн | ger-iin | 房子的 |
一個簡單句子也遵循同樣的邏輯。Би ном уншиж байна(Bi nom unshij baina)意思是「我正在讀一本書」:би「我」+ ном「書」+ уншиж байна「正在讀」。重要的教訓是:不要按英語語序逐詞翻譯,並期望句子還能成立。
詞彙與外來語
核心詞彙是蒙古語族的,但蒙古語透過宗教、貿易、帝國及現代地緣政治吸收了詞語。藏語和梵語層出現在佛教詞彙中;漢語接觸在內蒙古尤其重要;俄語和國際詞彙則在現代蒙古國十分顯著。
外來語不是隨機的裝飾。它們能幫助判斷文本的年代或辨識其地區,但也可能誤導譯者。一個看似熟悉的國際詞,可能有本地詞尾、不同的發音,或被蒙古語用法窄化的意義。
常用蒙古語短語
這些短語使用現代蒙古西里爾字母。羅馬化是學習輔助,並非單一的通用發音標準。
| 中文 | 蒙古語 | 羅馬化 |
|---|---|---|
| 你好 | Сайн уу? | Sain uu? |
| 你好嗎? | Сонин сайхан юу байна вэ? | Sonin saikhan yu baina ve? |
| 謝謝 | Баярлалаа | Bayarlalaa |
| 對不起 | Уучлаарай | Uuchlaarai |
| 是 | Тийм | Tiim |
| 不 | Үгүй | Ügüi |
| 再見 | Баяртай | Bayartai |
| 多少錢? | Энэ ямар үнэтэй вэ? | Ene yamar unetei ve? |
如果你只記得一句問候語,就從 Сайн уу? 開始。它簡短、辨識度高,而且比更長的正式問候語 Сайн байна уу? 更容易發音。
蒙古語難學嗎?
對英語使用者而言,蒙古語之所以有挑戰性,主要是因為好幾個陌生的系統同時出現:
- 書寫: 西里爾字母可以學會,但 ө 和 ү 需要新的音拼習慣;傳統文字則另加一套閱讀系統。
- 文法: 後綴串與格詞尾把資訊放進詞內,而非放在英語式的獨立功能詞中。
- 發音: 母音和諧與母音長度讓細微的聲音差異具有意義。
- 資源: 喀爾喀西里爾字母的學習材料,比傳統蒙古文或較小的蒙古語族變體更容易找到。
困難集中在前期。一旦西里爾字母表與最常見的詞尾變得熟悉,句子就不再像孤立的符號,而開始顯現出一致的模式。
實用學習建議
- 先選擇喀爾喀西里爾字母。 它能讓你最廣泛地接觸當前蒙古語媒體與初學者教材。
- 配合音訊學習 ө 和 ү。 不要用最接近的英語母音取代這兩個音,然後指望上下文會修補差異。
- 把詞尾當作家族來學。 用數個名詞學習位置、來源、所屬與複數模式,而不是一次只背一個詞。
- 用兩遍讀一個短句。 先辨識後綴,再依該句的主語-賓語-動詞語序重新建構句意。
- 打好基礎後再加入傳統文字。 從標誌、名字及並列的西里爾字母例子開始,讓垂直版面有個已知的參照。
AI 翻譯與蒙古語
蒙古語是翻譯系統一個有用的壓力測試,因為它結合了低資源資料、豐富的後綴變化,以及真正的雙文字問題。一個系統可能產出看似流暢的英文,卻漏掉一個格詞尾、以不一致的方式將名字標準化,或錯誤解讀一個有歧義的傳統文字形式。
一份 2026 年 7 月的 arXiv 預印本,CoPiT,將傳統文字的蒙古語視為一種雙文字的低資源問題。它提出的工作流程先透過西里爾字母解決傳統文字的歧義,再進行翻譯,而非將兩種文字視為資源同樣充足。另一項 MM-Eval 基準測試發現,受測的語言模型在現代蒙古語的句法任務上表現優於更深入的語意任務。這些是研究發現,並不保證任何特定的翻譯工具在你的文件上都會表現良好。
OpenL 的蒙古語翻譯器 支援以蒙古語為目標語言,而 OpenL 的多格式工作流程涵蓋文字、圖片、螢幕截圖、PDF 與 Word 檔案。用它做第一輪翻譯,然後檢視文字、名字與詞尾。對於傳統文字的掃描檔,請在翻譯前檢查 OCR 輸出;如何從圖片和照片翻譯文字 涵蓋了這個準備步驟。對於可編輯的報告或學習材料,如何翻譯 Word 文件 有助於保留檔案結構。
務必檢視:
| 檢查項目 | 為什麼重要 |
|---|---|
| 文字 | 西里爾字母與傳統文字可能需要不同的 OCR 與渲染路徑 |
| 格詞尾 | 一個後綴可能改變誰做了什麼、在哪裡,或對誰做 |
| 名字 | 羅馬化與轉寫在不同來源之間可能有所不同 |
| 地區變體 | 喀爾喀、內蒙古與布里亞特材料不應隨意混用 |
| 格式 | 垂直文字複製到水平文件時可能損壞 |
蒙古語不是「只是西里爾字母」,也不是「只是草原的語言」。它是一種現代國家語言、一個相關變體的家族,以及一個在情境需要時仍會垂直流動的書寫傳統。
Sources
- World Bank: Mongolia population, total — 2025 population baseline; this is a country population figure, not a speaker count.
- Wikidata: Mongolian language — structured record for the dated estimate of 5.2 million speakers in 2005; used with an explicit age warning.
- Glottolog 5.3: Halh Mongolian — classification, Khalkha status, and 2025 language-resource metadata.
- Ministry of Foreign Affairs of the People’s Republic of China: Mongolia country profile — official country profile identifying Khalkha Mongolian as Mongolia’s main language.
- Unicode Standard, Chapter 13 — history, direction, and shaping requirements of the Mongolian script.
- Wikimedia Commons: Güyük Khan’s Stamp 1246 — public-domain vertical Mongolian script image used in the article.
- Omniglot: Mongolian alphabet, pronunciation and language — script history, varieties, Cyrillic notes, and sample text.
- Oxford University Press: The Phonology of Mongolian — linguistic reference for Khalkha vowel harmony and vowel length.
- WALS: Khalkha — comparative grammatical references for Khalkha Mongolian.
- Grambank: Halh Mongolian — structured grammar metadata and source bibliography.
- Omniglot: Mongolian phrases — phrase forms and romanization used in the common-phrases table.
- CoPiT: Cognitive Pivot Translation for Digraphic Low-Resource Mongolian in the Traditional Script — July 2026 preprint on traditional-script ambiguity and pivot translation.
- MM-Eval: A Hierarchical Benchmark for Modern Mongolian Evaluation in LLMs — benchmark findings on syntax, semantics, knowledge, and reasoning in Modern Mongolian.
- OpenL: Translate to Mongolian — official product page for Mongolian and multi-format translation support.